ДП — не формула, а порядок рассуждения: сформулируйте подзадачу словами, запишите переход, базу и порядок вычисления, назовите, где лежит ответ, и перемножьте число состояний на стоимость перехода. Если решение не складывается, почти всегда неточно определено состояние.
Динамическое программирование — это рекурсия без повторной работы
Возьмём лестницу из n ступенек, по которой можно шагать на одну или две ступеньки. На ступеньку n попадают либо с n − 1, либо с n − 2, значит, число способов равно сумме двух меньших ответов. Рекурсия по этой формуле верна, но очень медленна: она снова и снова пересчитывает одни и те же ступеньки. Для n = 25 наивная функция из примера ниже вызывается 242 785 раз, хотя разных подзадач всего 26.
В конспекте курса MIT 6.006 это сформулировано так: рекурсивный алгоритм задаёт граф вычислений, и о динамическом программировании говорят, когда зависимости подзадач пересекаются. Там же названы два способа избавиться от повторов: сверху вниз — рекурсия с запоминанием ответов (мемоизация) — и снизу вверх — решать подзадачи по порядку, обычно циклами. Само название, как отмечено в том же конспекте, придумал Ричард Беллман; слово «программирование» здесь означает составление плана, а не написание кода.
Пять шагов: состояние, переход, база, порядок, ответ
В MIT 6.006 схему решения называют SRTBOT: Subproblems, Relate, Topological order, Base cases, Original problem, Time. По-русски удобнее пять вопросов и оценка времени в конце. Самый важный шаг — первый: состояние нужно описать словами, полным предложением. «dp[i] — число способов оказаться на ступеньке i» — хорошее определение. «dp[i] — ответ для i» — плохое: из него нельзя вывести ни переход, ни базу.
На собеседовании проговаривайте шаги вслух именно в этом порядке и до того, как начнёте писать код. Интервьюер видит ход рассуждения, а вы страхуетесь от главной ошибки — писать циклы, не понимая, что лежит в ячейке. Оценка времени получается почти автоматически: число состояний умножается на стоимость одного перехода.
| Шаг | Вопрос | Лестница: способы подняться на n ступенек шагами по 1 и 2 |
|---|---|---|
| Состояние | Что означает dp[i] словами? | dp[i] — число способов оказаться на ступеньке i |
| Переход | Как dp[i] выражается через меньшие состояния? | dp[i] = dp[i − 1] + dp[i − 2] |
| База | Какие значения известны без вычислений? | dp[0] = 1, dp[1] = 1 |
| Порядок | В каком порядке считать, чтобы нужное было готово? | i от 2 до n |
| Ответ | Где лежит ответ на исходную задачу? | dp[n] |
| Время | Сколько состояний и сколько стоит переход? | n состояний × O(1) = O(n) |
Задача 1. Лестница: мемоизация и табличный метод
Три версии одной функции показывают всю идею. Наивная рекурсия делает 242 785 вызовов. Версия с декоратором cache считает каждую ступеньку один раз: в статистике кеша 26 промахов — ровно по числу подзадач от 0 до 25. По документации Python, functools.cache появился в версии 3.9 и равносилен lru_cache(maxsize=None), а аргументы кешируемой функции должны быть хешируемыми. Табличная версия идёт снизу вверх и хранит только два последних значения, поэтому ей хватает O(1) памяти.
У мемоизации в Python есть практическое ограничение: глубина рекурсии. Интерпретатор ограничивает глубину стека, чтобы бесконечная рекурсия не обрушила процесс; лимит можно поднять через sys.setrecursionlimit, но документация предупреждает, что слишком высокое значение способно привести к падению. При лимите 1000 вызов ways_memo(5000) с пустым кешем у нас закончился ошибкой RecursionError. Поэтому для длинных цепочек зависимостей надёжнее табличный метод. На LeetCode это задача 70, Climbing Stairs, уровень Easy.
from functools import cache

calls = 0

def ways_naive(n):
    global calls
    calls += 1
    if n <= 1:                    # база: 0 или 1 ступенька
        return 1
    return ways_naive(n - 1) + ways_naive(n - 2)

@cache
def ways_memo(n):
    if n <= 1:
        return 1
    return ways_memo(n - 1) + ways_memo(n - 2)

def ways_table(n):
    prev, cur = 1, 1              # dp[0], dp[1]
    for _ in range(2, n + 1):
        prev, cur = cur, prev + cur
    return cur

print(ways_naive(25), "вызовов:", calls)
print(ways_memo(25), ways_memo.cache_info())
print(ways_table(25), ways_table(90))

# Вывод:
# 121393 вызовов: 242785
# 121393 CacheInfo(hits=23, misses=26, maxsize=None, currsize=26)
# 121393 4660046610375530309Задача 2. Рюкзак 0/1: брать или не брать
Есть предметы с весом и ценностью и рюкзак вместимостью W; каждый предмет можно взять не больше одного раза, нужно набрать максимальную ценность. Состояние — dp[i][w]: лучшая ценность, которую дают первые i предметов при вместимости w. Переход — выбор из двух вариантов: не брать предмет (dp[i − 1][w]) или взять, если он помещается (dp[i − 1][w − вес] + ценность). В примере четыре предмета и вместимость 7: ответ 9, взяты предметы с индексами 1 и 2 — их веса 3 и 4.
Время и память — O(n·W). Память сжимается до одного массива, но обходить его нужно справа налево: тогда dp[w − вес] ещё хранит значение без текущего предмета. При обходе слева направо предмет будет взят несколько раз — это уже другая задача, рюкзак с неограниченным числом копий. Та же схема «брать или не брать» решает задачу 416, Partition Equal Subset Sum (Medium): можно ли разбить массив на две части с равной суммой — то есть набрать подмножество, сумма которого равна половине общей.
def knapsack(weights, values, capacity):
    n = len(weights)
    # dp[i][w] — лучшая ценность из первых i предметов при вместимости w
    dp = [[0] * (capacity + 1) for _ in range(n + 1)]
    for i in range(1, n + 1):
        wt, val = weights[i - 1], values[i - 1]
        for w in range(capacity + 1):
            dp[i][w] = dp[i - 1][w]                       # не берём
            if wt <= w:                                   # берём
                dp[i][w] = max(dp[i][w], dp[i - 1][w - wt] + val)
    taken, w = [], capacity                               # восстановление
    for i in range(n, 0, -1):
        if dp[i][w] != dp[i - 1][w]:
            taken.append(i - 1)
            w -= weights[i - 1]
    return dp[n][capacity], taken[::-1]

def knapsack_1d(weights, values, capacity):
    dp = [0] * (capacity + 1)
    for wt, val in zip(weights, values):
        for w in range(capacity, wt - 1, -1):             # справа налево
            dp[w] = max(dp[w], dp[w - wt] + val)
    return dp[capacity]

weights, values = [1, 3, 4, 5], [1, 4, 5, 7]
print(knapsack(weights, values, 7))
print(knapsack_1d(weights, values, 7))

# Вывод:
# (9, [1, 2])
# 9Задача 3. Наибольшая общая подпоследовательность (LCS)
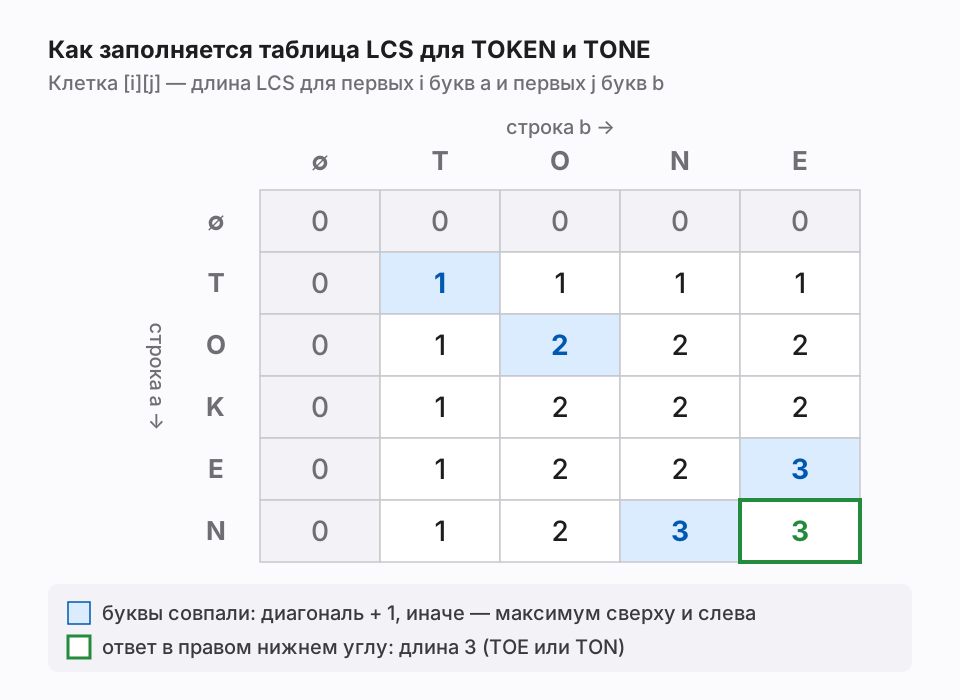
Подпоследовательность получается вычёркиванием символов без перестановки. Нужно найти самую длинную, общую для двух строк. Состояние двумерное: dp[i][j] — длина ответа для первых i символов строки a и первых j символов строки b. Если последние символы префиксов совпали, берём диагональную клетку и прибавляем единицу; если нет — лучший из двух вариантов, где один из символов отброшен: клетка сверху или клетка слева. Нулевые строка и столбец — база: с пустой строкой общего ничего нет.
Для TOKEN и TONE таблица из примера заканчивается числом 3. Саму подпоследовательность восстанавливают обратным проходом из правого нижнего угла: при совпадении символов идём по диагонали, иначе — туда, где значение не меньше. Программа вернула TOE; TON — столь же правильный ответ, какой из них получится, зависит от порядка сравнений. Время и память — O(n·m); если нужна только длина, достаточно двух строк таблицы. На LeetCode это задача 1143, уровень Medium.
def lcs(a, b):
    n, m = len(a), len(b)
    # dp[i][j] — длина LCS для a[:i] и b[:j]
    dp = [[0] * (m + 1) for _ in range(n + 1)]
    for i in range(1, n + 1):
        for j in range(1, m + 1):
            if a[i - 1] == b[j - 1]:
                dp[i][j] = dp[i - 1][j - 1] + 1
            else:
                dp[i][j] = max(dp[i - 1][j], dp[i][j - 1])
    out, i, j = [], n, m                  # восстановление ответа
    while i > 0 and j > 0:
        if a[i - 1] == b[j - 1]:
            out.append(a[i - 1])
            i, j = i - 1, j - 1
        elif dp[i - 1][j] >= dp[i][j - 1]:
            i -= 1
        else:
            j -= 1
    return dp, "".join(reversed(out))

table, answer = lcs("TOKEN", "TONE")
for row in table:
    print(row)
print(table[-1][-1], answer)

# Вывод:
# [0, 0, 0, 0, 0]
# [0, 1, 1, 1, 1]
# [0, 1, 2, 2, 2]
# [0, 1, 2, 2, 2]
# [0, 1, 2, 2, 3]
# [0, 1, 2, 3, 3]
# 3 TOEЗадача 4. Размен монет: почему жадный алгоритм ошибается
Даны номиналы монет и сумма; нужно набрать её минимальным числом монет, каждую можно брать сколько угодно раз. Первая мысль — жадно брать самую крупную монету. Контрпример из кода: номиналы 1, 3, 4 и сумма 6. Жадный алгоритм берёт 4 + 1 + 1 — три монеты, а оптимум — 3 + 3, две. Если вы подозреваете, что задача жадная, сначала поищите такой контрпример: одной минуты хватает, чтобы не потерять двадцать.
Состояние — dp[s]: минимум монет для суммы s. Переход перебирает последнюю монету: dp[s] = min(dp[s − c] + 1) по всем номиналам c, не превышающим s. База — dp[0] = 0. Недостижимые суммы помечены бесконечностью; если бесконечность осталась в dp[amount], ответа нет, и функция возвращает −1 — так и случилось для монеты 2 и суммы 3. Время — O(S·k), где S — сумма, а k — число номиналов; память — O(S). На LeetCode это задача 322, Coin Change, уровень Medium.
def min_coins(coins, amount):
    INF = float("inf")
    dp = [0] + [INF] * amount          # dp[s] — минимум монет для суммы s
    for s in range(1, amount + 1):
        for c in coins:
            if c <= s and dp[s - c] + 1 < dp[s]:
                dp[s] = dp[s - c] + 1
    return dp[amount] if dp[amount] != INF else -1

def greedy(coins, amount):
    count = 0
    for c in sorted(coins, reverse=True):
        count += amount // c
        amount %= c
    return count if amount == 0 else -1

print(min_coins([1, 3, 4], 6), greedy([1, 3, 4], 6))
print(min_coins([1, 2, 5], 11))
print(min_coins([2], 3))
print(min_coins([5, 10], 0))

# Вывод:
# 2 3
# 3
# -1
# 0Задача 5. Наибольшая возрастающая подпоследовательность (LIS)
Нужно найти длину самой длинной строго возрастающей подпоследовательности массива. Здесь важна тонкость в определении состояния: dp[i] — длина лучшей подпоследовательности, которая заканчивается именно в элементе i. Без слова «именно» переход не записать: чтобы продолжить подпоследовательность элементом nums[i], нужно знать её последний элемент. Ответ поэтому не dp[n − 1], а максимум по всему массиву. Это решение работает за O(n²).
Быстрая версия за O(n log n) хранит массив tails: tails[k] — наименьший возможный последний элемент возрастающей подпоследовательности длины k + 1. Массив всегда отсортирован, поэтому место для очередного числа ищется бинарным поиском; bisect_left, по документации, возвращает позицию вставки левее равных элементов, что и обеспечивает строгое возрастание. Учтите, что tails в общем случае не является самой подпоследовательностью: гарантированно верна только его длина. На LeetCode это задача 300, уровень Medium.
from bisect import bisect_left

def lis_quadratic(nums):
    # dp[i] — длина лучшей возрастающей подпоследовательности,
    # которая заканчивается ровно в nums[i]
    dp = [1] * len(nums)
    for i in range(len(nums)):
        for j in range(i):
            if nums[j] < nums[i]:
                dp[i] = max(dp[i], dp[j] + 1)
    return max(dp, default=0), dp

def lis_fast(nums):
    tails = []      # tails[k] — наименьший хвост подпоследовательности длины k + 1
    for x in nums:
        pos = bisect_left(tails, x)
        if pos == len(tails):
            tails.append(x)
        else:
            tails[pos] = x
    return len(tails), tails

nums = [5, 2, 8, 6, 3, 6, 9, 7]
print(lis_quadratic(nums))
print(lis_fast(nums))
print(lis_fast([4, 4, 4]), lis_fast([]))

# Вывод:
# (4, [1, 1, 2, 2, 2, 3, 4, 4])
# (4, [2, 3, 6, 7])
# (1, [4]) (0, [])Как узнать ДП-задачу на собеседовании и где ошибаются
Признаки в условии: спрашивают число способов, минимальную или максимальную стоимость либо саму возможность что-то получить; на каждом шаге есть выбор из нескольких вариантов; жадное решение ломается на контрпримере; полный перебор экспоненциален, а ограничения невелики. Тема большая: 14 ноября 2026 года тегом Dynamic Programming на LeetCode были отмечены 689 задач, а в списке NeetCode 150 на два раздела о ДП приходятся 23 задачи. Начинать стоит с одномерных состояний, затем переходить к двумерным.
Пять разобранных задач покрывают основные формы состояния: префикс, префикс с ресурсом, пара префиксов, значение суммы, позиция последнего элемента. Новую задачу сначала попробуйте свести к одной из них. Если переход не записывается, добавьте в состояние то, чего не хватает для выбора — ещё один индекс, остаток ресурса, флаг, — и повторите пять шагов.
- Состояние не сформулировано словами — отсюда ошибки на единицу в индексах.
- Забыта база или недостижимые состояния: в размене монет нужны бесконечность и ответ −1.
- Неверный порядок обхода: одномерный рюкзак 0/1 при проходе слева направо берёт предмет несколько раз.
- Мемоизация по изменяемым аргументам: список нельзя сделать ключом кеша, передавайте индексы или кортежи.
- Не названа сложность: число состояний, умноженное на стоимость перехода.
| Задача | Состояние | Время | Память |
|---|---|---|---|
| Лестница | dp[i] — число способов оказаться на ступеньке i | O(n) | O(1) |
| Рюкзак 0/1 | dp[i][w] — лучшая ценность первых i предметов при вместимости w | O(n·W) | O(n·W), сжимается до O(W) |
| LCS | dp[i][j] — длина ответа для префиксов a[:i] и b[:j] | O(n·m) | O(n·m); только для длины — O(min(n, m)) |
| Размен монет | dp[s] — минимум монет для суммы s | O(S·k) | O(S) |
| LIS | dp[i] — длина лучшей подпоследовательности с концом в i | O(n²) или O(n log n) | O(n) |
Коротко
Частые вопросы
Что такое динамическое программирование простыми словами?
Это приём, при котором большую задачу решают через ответы на меньшие такие же задачи и каждый ответ запоминают, чтобы не считать повторно. Он подходит, когда подзадачи пересекаются: например, число способов подняться на ступеньку зависит от двух предыдущих ступенек, а те — от своих предыдущих.
Чем мемоизация отличается от табличного метода?
Мемоизация идёт сверху вниз: это обычная рекурсия, которая сохраняет уже посчитанные ответы. Табличный метод идёт снизу вверх: цикл заполняет массив от базовых случаев к ответу. Результат одинаковый; таблица не упирается в глубину рекурсии и часто позволяет сэкономить память, мемоизацию проще написать по формуле.
Как понять, что задача решается динамическим программированием?
Ищите три признака: спрашивают количество способов, оптимум или достижимость; решение строится последовательностью выборов; одни и те же подзадачи возникают при разных выборах. Если жадная стратегия ломается на маленьком контрпримере, а полный перебор экспоненциален, почти наверняка нужно ДП.
Нужно ли знать динамическое программирование для собеседования?
В популярных списках для подготовки тема занимает заметное место: в NeetCode 150 это 23 задачи из 150, в официальном плане LeetCode 75 — два раздела по четыре задачи. Спросят ли ДП именно вас, зависит от компании и роли, но базовые задачи вроде лестницы и размена монет стоит уметь решать уверенно.
Источники
Источники и редакционная политика
Сведения проверены 14 ноября 2026 г. Ссылки рядом с разделами указывают источники фактов и технических объяснений. Выводы, учебные сценарии и рекомендации по подготовке — редакционная работа RecallDeck.
- MIT OpenCourseWare 6.006 (весна 2020), лекция 15: Dynamic Programming, Part 1
- MIT 6.006: конспект лекции 15 (PDF)
- Документация Python: functools (cache, lru_cache)
- Документация Python: sys.setrecursionlimit
- Документация Python: bisect
- LeetCode: каталог задач (Problems)
- LeetCode: учебный план LeetCode 75
- NeetCode: список NeetCode 150
- LeetCode 70. Climbing Stairs
- LeetCode 416. Partition Equal Subset Sum
- LeetCode 1143. Longest Common Subsequence
- LeetCode 322. Coin Change
- LeetCode 300. Longest Increasing Subsequence
- Яндекс: хендбук «Основы алгоритмов»
От чтения к воспроизведению
Отрепетируйте полный цикл интервью.
RecallDeck возвращает сложные темы по расписанию и помогает удерживать в памяти язык, SQL, архитектуру и поведенческие истории.