Сложность — это закон роста числа шагов и памяти при росте входа, а не время на вашем ноутбуке. Считайте вложенность циклов и деление пополам, для рекурсии — число вызовов и глубину стека. Всегда называйте случай (худший, средний, амортизированный) и переменные, от которых зависит оценка.
Как оценить код: циклы, вложенность и деление пополам
Начинайте с вопроса «сколько раз выполнится самая внутренняя строка». Один цикл по n — n повторений, два вложенных — n², внутренний цикл от i до n — n(n + 1)/2, что тоже Θ(n²): константы и младшие члены отбрасываются. Цикл, который на каждом шаге делит n пополам, делает около log₂ n итераций, а удвоение j внутри цикла по i даёт n · log n.
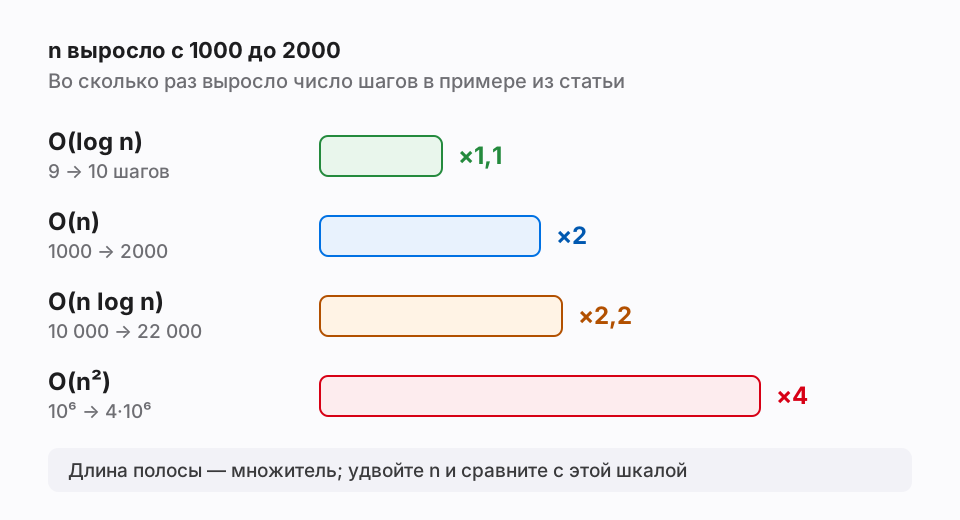
Программа считает итерации для n = 1000 и n = 2000. Первая строка вывода: 1000 1000 1000000 500500 9 10000, вторая: 2000 2000 4000000 2001000 10 22000. Удвоение входа выдаёт класс: линейный счётчик вырос вдвое, квадратичные — вчетверо, логарифм прибавил один шаг, n log n — в 2,2 раза. Этот тест удвоения работает и в уме: удвойте вход и спросите, что станет с внутренним циклом.
def linear(n):
    return sum(1 for i in range(n))

def nested(n):
    return sum(1 for i in range(n) for j in range(n))

def triangle(n):                       # внутренний цикл начинается с i
    return sum(1 for i in range(n) for j in range(i, n))

def halving(n):
    steps = 0
    while n > 1:
        n //= 2
        steps += 1
    return steps

def doubling_inner(n):                 # j = 1, 2, 4, ... < n внутри цикла по i
    steps = 0
    for i in range(n):
        j = 1
        while j < n:
            j *= 2
            steps += 1
    return steps

for n in (1_000, 2_000):
    print(n, linear(n), nested(n), triangle(n), halving(n), doubling_inner(n))
Рекурсия: число вызовов и глубина стека
Для рекурсии считайте две вещи: сколько всего вызовов и насколько глубоко они вкладываются. Наивный Фибоначчи на каждом уровне порождает два вызова, и их число растёт экспоненциально: программа печатает 21891 вызов для n = 20 и 242785 для n = 25, то есть 2·F(n + 1) − 1. С functools.cache каждое значение считается один раз: cache_info показывает misses=26 и hits=23, время становится линейным.
Память рекурсии — это глубина стека, а не число вызовов. У мемоизированной версии глубина n, и вызов fib_memo(5000) при лимите 1000 (вывод sys.getrecursionlimit() в CPython 3.12 и 3.14) падает с RecursionError: maximum recursion depth exceeded. Итеративный вариант с двумя переменными работает за O(n) времени и O(1) памяти, как и описано на cp-algorithms. Для «разделяй и властвуй» помогает рекуррентность: T(n) = 2T(n/2) + n даёт n log n.
import sys
from functools import cache

calls = 0
def fib_naive(n):
    global calls
    calls += 1
    return n if n < 2 else fib_naive(n - 1) + fib_naive(n - 2)

@cache
def fib_memo(n):
    return n if n < 2 else fib_memo(n - 1) + fib_memo(n - 2)

for n in (20, 25):
    calls = 0
    print(n, fib_naive(n), calls)

print(fib_memo(25), fib_memo.cache_info())
print(sys.getrecursionlimit())
try:
    fib_memo.cache_clear()
    fib_memo(5000)                     # глубина рекурсии ~5000 кадров
except RecursionError as e:
print(type(e).__name__, e)Худший, средний и лучший случай — это не O, Θ и Ω
Частая путаница: «O — худший случай, Ω — лучший». На самом деле случай выбирает, какую функцию мы оцениваем — время на худшем входе, среднее по входам или время на лучшем входе, — а нотация говорит, как эту функцию ограничить: O — сверху, Ω — снизу, Θ — с двух сторон. Поэтому корректно сказать: «в худшем случае быстрая сортировка работает за Θ(n²), в среднем — за Θ(n log n)».
Формально «бинарный поиск — O(n)» тоже верно, ведь O — только верхняя граница, но такой ответ бесполезен: от вас ждут точную оценку. Если интервьюер спрашивает про лучший случай, уточните реализацию. Пузырьковая сортировка без флага обмена делает все сравнения даже на отсортированном массиве, а с флагом останавливается после одного прохода — это разобрано в лекции UCSB CS9.
- O(f) — растёт не быстрее f с точностью до константы.
- Ω(f) — растёт не медленнее f.
- Θ(f) — и то и другое сразу; это и есть «точная оценка».
- Случай — худший, средний или амортизированный — называйте отдельно, словами.
Амортизированная сложность и память
list.append в CPython работает за амортизированное O(1). Документация по сложности встроенных типов оговаривает, что отдельная операция может стоить O(n) при перевыделении буфера, но эта цена распределяется на много операций. Программа считает перевыделения через sys.getsizeof: 28 на 1000 добавлений, 47 на 10 000, 66 на 100 000 и 86 на миллион. Вход вырос в десять раз — перевыделений стало примерно на двадцать больше: буфер растёт геометрически, и суммарное копирование остаётся линейным.
Память оценивают так же, как время, но отдельно от входных данных. Ловушки собеседования: срез xs[1:] копирует элементы и стоит O(k), поэтому рекурсия со срезом превращает линейный обход в квадратичный; стек рекурсии — тоже память; dict и set дают O(1) только в среднем, а при совпадающих хешах — O(n). Число перевыделений — деталь реализации: в 3.12 и 3.14 оно совпало, но гарантией не является.
import sys

def count_resizes(n):
    xs, resizes, size = [], 0, sys.getsizeof([])
    for i in range(n):
        xs.append(i)
        new_size = sys.getsizeof(xs)
        if new_size != size:           # буфер списка перевыделен
            resizes, size = resizes + 1, new_size
    return resizes

for n in (1_000, 10_000, 100_000, 1_000_000):
print(n, count_resizes(n))Таблица 1: сортировки, поиск, Евклид и Фибоначчи
Здесь n — размер входа, для Евклида — числа a и b. Каждая строка сверена с источником: быстрая сортировка — с курсом Принстона (в среднем около 2n ln n сравнений, в худшем около n²/2), пузырёк — с лекцией UCSB, бинарный поиск, Евклид и линейный Фибоначчи — с cp-algorithms. Рост наивного Фибоначчи следует из подсчёта вызовов выше и формулы Бине: F(n) растёт как φⁿ. Память указана дополнительная, без самого входа. Стек быстрой сортировки равен глубине дерева разбиений: log n при сбалансированных разбиениях и n при вырожденных.
Две строки вызывают больше всего вопросов. Худший случай быстрой сортировки реален: на страницах того же курса приведены входы, на которых системная сортировка примитивных типов в Java 6 уходила в квадратичное время и переполняла стек, поэтому реализации перемешивают вход или выбирают опорный элемент случайно. У Евклида худший вход — соседние числа Фибоначчи, а за два шага большее число уменьшается как минимум вдвое, отсюда логарифм.
| Алгоритм | Время | Доп. память | Заметка |
|---|---|---|---|
| Пузырьковая сортировка | Θ(n²) худший и средний | O(1) | с флагом обмена лучший O(n) |
| Быстрая сортировка | Θ(n log n) средний, Θ(n²) худший | стек O(log n) в среднем | перемешивание защищает |
| Бинарный поиск | O(log n) | O(1) итеративно | нужен отсортированный массив |
| Алгоритм Евклида | O(log min(a, b)) | O(1) итеративно | худший вход — числа Фибоначчи |
| Фибоначчи наивно | Θ(φⁿ), φ ≈ 1,618 | O(n) стек | 2·F(n + 1) − 1 вызовов |
| Фибоначчи с мемоизацией | O(n) | O(n) кэш и стек | итеративно — O(1) памяти |
Таблица 2: Дейкстра, Прим и Краскал
Для графов n — число вершин, m — число рёбер. У Дейкстры и Прима оценка зависит от того, как искать следующую вершину. Проход по массиву стоит O(n) на каждый выбор, итого O(n² + m) — это оптимально для плотных графов, где m близко к n². Двоичная куча делает извлечение и обновление за O(log n), и получается O((n + m) log n): выгодно на разреженных графах, на плотных — хуже массива.
У Краскала время определяет сортировка рёбер — O(m log m), а это то же самое, что O(m log n): в графе без кратных рёбер m < n², поэтому log m < 2 log n. Операции DSU с эвристиками почти константны. Модуль heapq в Python не умеет менять приоритет элемента на месте, поэтому в кучу кладут новую пару, а устаревшие пропускают при извлечении — документация heapq предлагает похожий приём с пометкой удалённых записей. cp-algorithms подчёркивает, что без этой проверки сложность может вырасти до O(nm). Деталь любят на собеседовании: почему в куче дубликаты и что будет, если убрать проверку устаревшей пары.
| Алгоритм | Время | Когда выбирать |
|---|---|---|
| Дейкстра, минимум по массиву | O(n² + m) | плотный граф |
| Дейкстра, двоичная куча | O((n + m) log n) | разреженный граф |
| Прим, массив min_e | O(n²) | плотный граф |
| Прим, куча или set | O(m log n) | разреженный граф |
| Краскал + DSU | O(m log n) | граф задан списком рёбер |
Как отвечать на собеседовании и что повторить
Отвечайте в одном формате: «время O(…) в худшем случае, дополнительная память O(…), где n — …». Если оценка зависит от двух параметров, не сводите их к одному: O(n + m) у обхода графа честнее, чем O(n²). Амортизацию называйте явно и будьте готовы показать, какая отдельная операция дорогая. На уточнение про рекурсию отвечайте глубиной стека, а не числом вызовов.
Для тренировки берите код из прошлых задач, проставляйте сложность каждой функции до запуска и проверяйте себя тестом удвоения: добавьте счётчик в самый внутренний цикл, прогоните n и 2n и сравните множитель со шкалой на рисунке. Если множитель плавает, ищите скрытую работу — срез, поиск в списке, конкатенацию строк в цикле. Таблицы из статьи удобно превратить в карточки «алгоритм → время, память, когда выбирать»: в интервальных повторениях RecallDeck такие пары закрепляются надёжнее, чем при перечитывании.
Коротко
Частые вопросы
Что важнее на собеседовании: время или память?
Обычно сначала спрашивают время, но сильный ответ называет обе оценки и компромисс между ними. Мемоизация, хеш-таблица и предподсчёт покупают время памятью. Если интервьюер ограничивает память, это меняет выбор решения, а не только формулировку ответа.
Почему в O(log n) не пишут основание логарифма?
Логарифмы по разным основаниям отличаются постоянным множителем: log₂ n = log₁₀ n / log₁₀ 2. O-нотация отбрасывает константы, поэтому O(log n) одинаково для деления пополам и на десять. Основание важно только при точном подсчёте шагов.
Какая сложность у сортировки в Python?
Документация CPython по сложности встроенных типов указывает O(n log n) для list.sort в худшем случае; уже упорядоченный вход сортируется за O(n) сравнений. sorted сначала копирует данные в новый список, поэтому добавляет O(n) памяти. Если ключ сортировки дорогой, учтите и его: key вычисляется один раз для каждого элемента.
Источники
Источники и редакционная политика
Сведения проверены 7 ноября 2026 г. Ссылки рядом с разделами указывают источники фактов и технических объяснений. Выводы, учебные сценарии и рекомендации по подготовке — редакционная работа RecallDeck.
От чтения к воспроизведению
Отрепетируйте полный цикл интервью.
RecallDeck возвращает сложные темы по расписанию и помогает удерживать в памяти язык, SQL, архитектуру и поведенческие истории.