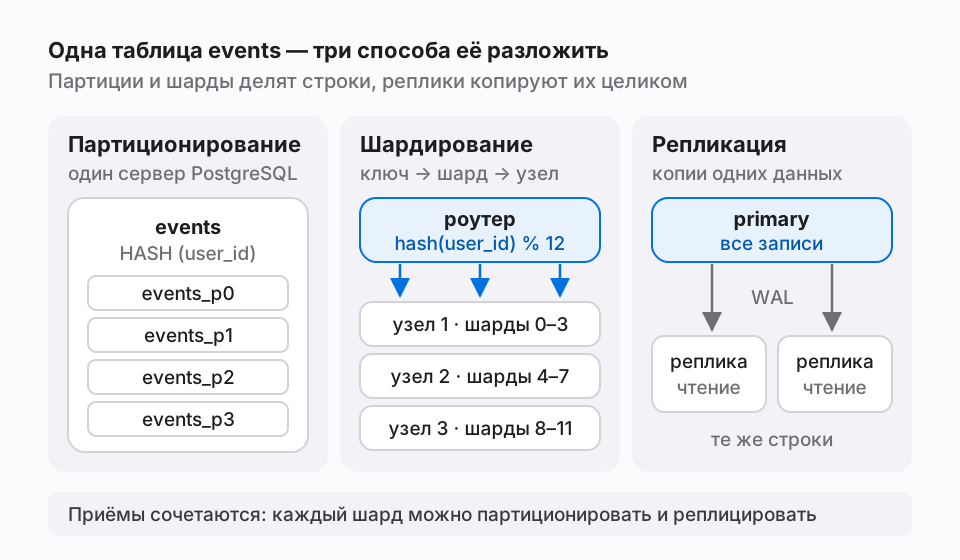
Партиционирование помогает управлять большой таблицей внутри одного узла, шардирование выводит данные за пределы одного узла, репликация помогает пережить отказ и разгрузить чтение. Шардируйте последним и по ключу, который есть в большинстве запросов и удерживает бизнес-операцию в одном шарде.
Три понятия, которые путают
Декларативное партиционирование PostgreSQL делит таблицу по ключу на партиции: по диапазонам (range), по списку значений (list) или по остатку от деления хеша (hash). Родительская таблица виртуальная и своих данных не хранит, строки лежат в партициях. Всё это остаётся внутри одного инстанса: общий WAL, общие транзакции и одна машина со своими CPU, памятью и диском.
Шардирование распределяет строки между независимыми серверами, у каждого свои ресурсы. Кто-то должен знать, на каком узле лежит ключ: приложение, прокси или расширение базы. Документация Citus так и определяет шардирование — горизонтальное разбиение данных между несколькими серверами. Репликация решает другую задачу: копирует весь набор данных, чтобы пережить отказ узла и распределить чтения, но запись в схеме с одним primary не масштабирует. На собеседовании говорите «партиционирование внутри узла» и «шардирование между узлами» — так не возникнет путаницы с термином «горизонтальное партиционирование».
Пример: hash-партиции в PostgreSQL 17
Скрипт создаёт таблицу events с партиционированием HASH (user_id) на четыре партиции (MODULUS 4, REMAINDER от 0 до 3), вставляет по 10 событий для 1000 пользователей и собирает статистику. Запускайте его в пустой базе через psql -f. Распределение получилось таким: events_p0 — 2590 строк, events_p1 — 2340, events_p2 — 2760, events_p3 — 2310. Хеш не обещает точного равенства: на тысяче ключей перекос в несколько сотен строк нормален. Пользователь 42 оказался в events_p2.
Первичный ключ включает user_id не случайно. Попытка добавить UNIQUE (id) завершилась ошибкой: unique constraint on partitioned table must include all partitioning columns. Документация объясняет причину: каждый индекс обеспечивает уникальность только внутри своей партиции. В шардированной системе та же проблема острее — глобальную уникальность придётся обеспечивать ключом, который содержит ключ шардирования, или генератором идентификаторов вне базы.
CREATE TABLE events (
  user_id bigint NOT NULL,
  id      bigint NOT NULL,
  kind    text   NOT NULL,
  PRIMARY KEY (user_id, id)
) PARTITION BY HASH (user_id);
CREATE TABLE events_p0 PARTITION OF events FOR VALUES WITH (MODULUS 4, REMAINDER 0);
CREATE TABLE events_p1 PARTITION OF events FOR VALUES WITH (MODULUS 4, REMAINDER 1);
CREATE TABLE events_p2 PARTITION OF events FOR VALUES WITH (MODULUS 4, REMAINDER 2);
CREATE TABLE events_p3 PARTITION OF events FOR VALUES WITH (MODULUS 4, REMAINDER 3);

INSERT INTO events
SELECT u, n, 'view' FROM generate_series(1, 1000) u, generate_series(1, 10) n;
ANALYZE events;

SELECT tableoid::regclass AS part, count(*) FROM events GROUP BY 1 ORDER BY 1;
SELECT tableoid::regclass AS part FROM events WHERE user_id = 42 LIMIT 1;

EXPLAIN (COSTS OFF) SELECT count(*) FROM events WHERE user_id = 42;
EXPLAIN (COSTS OFF) SELECT count(*) FROM events WHERE kind = 'view';

PREPARE by_user(bigint) AS SELECT count(*) FROM events WHERE user_id = $1;
SET plan_cache_mode = force_generic_plan;
EXPLAIN (COSTS OFF) EXECUTE by_user(42);Partition pruning: что показал EXPLAIN
Для WHERE user_id = 42 планировщик доказал, что подходящие строки могут лежать только в events_p2, и в плане осталась одна партиция с поиском по её индексу events_p2_pkey. Запрос по kind не содержит ключа партиционирования, поэтому план собирает Append по всем четырём партициям. Это локальный аналог scatter-gather в шардированной системе: чем больше частей, тем дороже запрос без ключа.
Третий план — подготовленный запрос в режиме plan_cache_mode = force_generic_plan. Значение параметра при планировании неизвестно, поэтому партиции отсекаются при инициализации исполнения, и в плане видна строка Subplans Removed: 3. Документация описывает оба этапа отсечения и параметр enable_partition_pruning, включённый по умолчанию. Практический вывод: держите ключ партиционирования в WHERE горячих запросов и партиционируйте действительно большие таблицы — по ориентиру документации, больше оперативной памяти сервера.
-- WHERE user_id = 42
 Aggregate
   ->  Bitmap Heap Scan on events_p2 events
         Recheck Cond: (user_id = 42)
         ->  Bitmap Index Scan on events_p2_pkey
               Index Cond: (user_id = 42)

-- WHERE kind = 'view'
 Aggregate
   ->  Append
         ->  Seq Scan on events_p0 events_1
               Filter: (kind = 'view'::text)
         ->  Seq Scan on events_p1 events_2
               Filter: (kind = 'view'::text)
         ->  Seq Scan on events_p2 events_3
               Filter: (kind = 'view'::text)
         ->  Seq Scan on events_p3 events_4
               Filter: (kind = 'view'::text)

-- EXECUTE by_user(42), generic plan
 Aggregate
   ->  Append
         Subplans Removed: 3
         ->  Bitmap Heap Scan on events_p2 events_1
               Recheck Cond: (user_id = $1)
               ->  Bitmap Index Scan on events_p2_pkey
Index Cond: (user_id = $1)Шардирование: ключ, роутинг и решардинг
Ключ шардирования определяет почти всё. Хороший ключ имеет много значений, равномерно распределяет нагрузку, присутствует в большинстве запросов и держит связанные данные вместе: user_id, tenant_id, customer_id. Стратегии раскладки различаются компромиссами: hash даёт ровное распределение, но запрос по диапазону идёт во все шарды; range сохраняет диапазоны локальными, но растущий ключ вроде времени создаёт горячий шард; справочник «ключ → шард» гибок при переносе клиентов, но добавляет поиск и компонент, который обязан быть доступен.
В самом PostgreSQL нет встроенного распределения таблицы по серверам. Партиция может быть внешней таблицей через postgres_fdw, но документация предупреждает: соответствие данных правилу партиционирования тогда на совести пользователя. Расширение Citus добавляет координатор, который по своим метаданным отправляет запрос на один рабочий узел или распараллеливает его, а таблицы распределяет по distribution column функцией create_distributed_table. Строки хранятся во множестве шардов вида table_1001, table_1002, поэтому при росте кластера переносят шарды целиком.
- hash(key) % N при смене N переносит большинство ключей — заводите логических шардов больше, чем узлов.
- Растущий ключ при range-раскладке концентрирует запись на последнем шарде.
- Клиент-гигант перегружает свой шард при любой стратегии; в Citus для этого есть isolate_tenant_to_new_shard.
Кросс-шардовые запросы и транзакции
Запрос без ключа шардирования уходит во все шарды, а результаты сливаются в одном месте. Задержка определяется самым медленным шардом, ORDER BY с LIMIT и агрегаты требуют второго этапа, а JOIN таблиц с разными ключами заставляет гонять данные по сети. Поэтому связанные таблицы шардируют по одному ключу: заказы и их позиции — обе по customer_id, для чего в позиции добавляют customer_id. В Citus этот приём называется co-location.
Транзакция, которая меняет два шарда, — это две локальные транзакции. Атомарный коммит требует двухфазного протокола: в PostgreSQL это PREPARE TRANSACTION, но документация прямо пишет, что команда предназначена для внешнего менеджера транзакций, а max_prepared_transactions по умолчанию равен нулю. Внешние ключи и уникальность между шардами база не проверит. Лучшая защита — ключ, при котором бизнес-операция почти всегда касается одного шарда, а редкие межшардовые процессы — саги с компенсациями.
Что выбрать: таблица решений
Обычный порядок такой: индексы и разбор запросов, затем партиционирование ради обслуживания больших таблиц, затем реплики для чтения и отказоустойчивости. Шардирование — последний шаг, потому что меняет контракт приложения: каждый запрос должен знать ключ, а часть гарантий базы переезжает в код. Документация PostgreSQL отдельно предупреждает, что больше партиций — не всегда лучше: планирование замедляется, если после отсечения остаётся много партиций.
На собеседовании проговаривайте связку «проблема → приём → цена». Например: «Таблица событий быстро растёт, данные старше 90 дней удаляем — range-партиции по месяцам дадут DROP партиции вместо долгого DELETE; если упрёмся в запись, шардируем по user_id и переносим логические шарды». Цифры в таком ответе — ваши допущения, назовите их явно.
| Проблема | Приём | Чего он не даст |
|---|---|---|
| Старые данные удаляют по дате | Range-партиции, DETACH и DROP | Больше CPU и диска |
| Primary не справляется с чтением | Реплики для чтения | Масштабирования записи |
| Отказ сервера недопустим | Реплика и failover | Меньшего объёма на узел |
| Запись не влезает в сервер | Шардирование по ключу | Простых JOIN между шардами |
| SaaS, данные клиента вместе | Шардирование по tenant_id | Ровной нагрузки от гигантов |
Практика: повторите эксперимент
Замените HASH на RANGE по дате, создайте партиции по месяцам и посмотрите, какие из них остаются в плане для запроса за неделю. Затем письменно ответьте, какой ключ шардирования вы бы выбрали для маркетплейса и какие запросы станут кросс-шардовыми.
Для чтения планов пригодится разбор EXPLAIN ANALYZE, а для задачи целиком — разбор system design маркетплейса и сборник вопросов по PostgreSQL.
Коротко
Частые вопросы
Шардирование и репликация — это одно и то же?
Нет. Шард хранит часть данных, реплика — копию. На практике их сочетают: каждый шард реплицируют, чтобы отказ одного сервера не делал недоступной часть пользователей. Шардирование масштабирует объём и запись, репликация — чтение и отказоустойчивость.
Ускоряет ли партиционирование любой запрос?
Нет. Выигрыш появляется, когда условие на ключ позволяет отсечь партиции или когда нужно быстро удалять старые данные. Запрос без ключа сканирует все партиции, а при большом числе оставшихся партиций растут время планирования и расход памяти.
Сколько шардов заводить сразу?
Универсального числа нет. Полезно заводить логических шардов заметно больше, чем серверов, чтобы при росте переносить шарды целиком без пересчёта ключей. Слишком мелкое дробление усложняет обслуживание, поэтому исходите из прогноза данных и нагрузки на несколько лет.
Можно ли шардировать PostgreSQL без расширений?
Да, на уровне приложения: библиотека выбирает подключение по ключу. Другой путь — внешние партиции через postgres_fdw, но соответствие данных правилу партиционирования тогда обеспечиваете вы. Расширения вроде Citus берут на себя роутинг, распределённые запросы и перенос шардов.
Источники
Источники и редакционная политика
Сведения проверены 7 ноября 2026 г. Ссылки рядом с разделами указывают источники фактов и технических объяснений. Выводы, учебные сценарии и рекомендации по подготовке — редакционная работа RecallDeck.
От чтения к воспроизведению
Отрепетируйте полный цикл интервью.
RecallDeck возвращает сложные темы по расписанию и помогает удерживать в памяти язык, SQL, архитектуру и поведенческие истории.