Kafka выбирают, когда события нужно хранить, перечитывать и обрабатывать по порядку ключа; RabbitMQ — когда важны маршрутизация, поштучные подтверждения и очереди задач. Обе системы по умолчанию дают at-least-once, поэтому идемпотентный потребитель нужен в любом случае.
Главное различие: лог или очередь
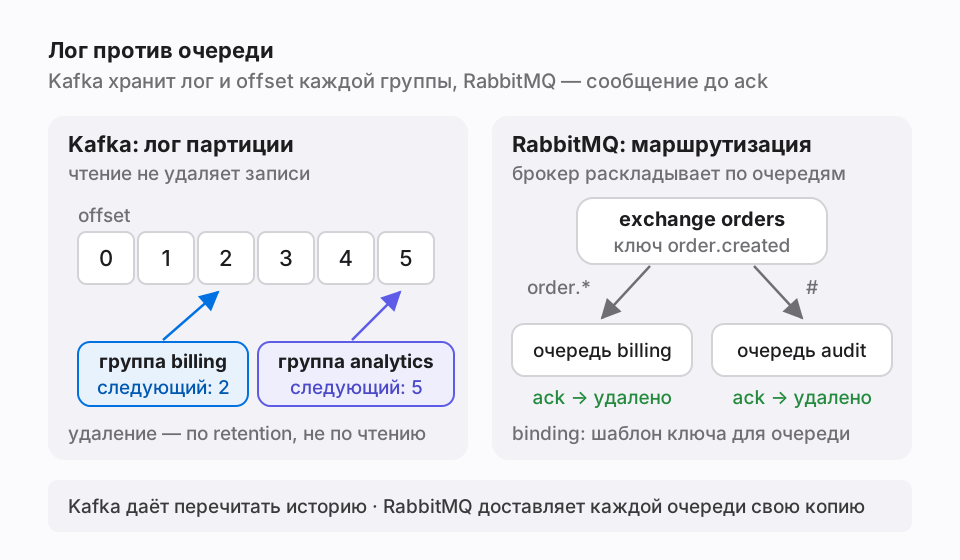
В Kafka топик разделён на партиции, каждая — упорядоченный лог. Событие дописывается в одну партицию; события с одинаковым ключом попадают в одну партицию, и любой потребитель читает её в порядке записи. Чтение ничего не удаляет: срок хранения задаётся настройкой топика, а брокер по умолчанию держит лог 168 часов (log.retention.hours). Позиция потребителя в партиции — одно число, offset следующей записи, поэтому подтверждение чтения обходится дёшево.
В RabbitMQ издатель отправляет сообщение в exchange, а тот по правилам bindings кладёт его в ноль или больше очередей; типы exchange — direct, fanout, topic и headers. Очередь отдаёт сообщения в порядке FIFO, потребитель подтверждает обработку, после чего брокер может удалить сообщение. Иначе говоря, Kafka хранит данные и позицию каждой группы потребителей, а RabbitMQ хранит состояние доставки каждого сообщения.
Параллелизм и порядок
Каждую партицию в Kafka в любой момент читает ровно один участник consumer group. Отсюда два следствия: порядок гарантирован внутри партиции, а не во всём топике, и параллелизм группы ограничен числом партиций. Разные группы читают один топик независимо — так аналитика и биллинг получают одни и те же события без копирования. Ключ сообщения — главный инструмент: всё, что должно идти по порядку, например события одного заказа, публикуют с одним ключом.
Очередь RabbitMQ обслуживает конкурирующих потребителей: брокер выдаёт сообщения в порядке FIFO, но фактический порядок меняют приоритеты и, при нескольких активных потребителях, повторная доставка после nack с requeue или закрытия канала с неподтверждёнными сообщениями. Документация предлагает два способа его сохранить: stream или очередь с single active consumer. Для параллельной обработки с порядком по сущности сообщения раскладывают exchange типа x-modulus-hash по нескольким очередям, у каждой из которых один активный потребитель.
Повторное чтение и RabbitMQ Streams
Replay в Kafka — штатная операция: новая группа читает топик с начала в пределах retention, а существующую можно перемотать на нужный offset. Так пересобирают проекции, подключают новый сервис к истории или переобрабатывают данные после исправления бага. Компактизация лога хранит как минимум последнее значение для каждого ключа, что подходит для восстановления состояния после сбоя.
Классические и quorum-очереди RabbitMQ читаются разрушающе: после подтверждения сообщение исчезает. Streams закрывают этот пробел: это append-only лог, который можно читать многократно до истечения срока, всегда персистентный и реплицированный. Потребитель выбирает точку старта аргументом x-stream-offset, например first или last, а super streams делят большой поток на партиции. Тезис «RabbitMQ не умеет replay» устарел, но для всех возможностей streams документация рекомендует отдельный бинарный протокол и его клиенты.
Гарантии доставки: что обещает документация
С версии 0.11 producer Kafka поддерживает идемпотентную доставку: брокер выдаёт ему ID и отбрасывает повторы по порядковому номеру. В текущих версиях enable.idempotence включён по умолчанию, если нет конфликтующих настроек: нужны acks=all, retries больше нуля и не больше пяти запросов в полёте на соединение. Транзакции атомарно пишут в несколько партиций, а транзакционный producer вместе с потребителем в режиме read_committed даёт exactly-once для цепочки «прочитать — обработать — записать» внутри Kafka. Для внешних систем нужна их кооперация, иначе по умолчанию — at-least-once.
В RabbitMQ гарантии строятся на подтверждениях: по документации, с ними доставка как минимум однократная, без них возможна потеря и остаётся at-most-once. Publisher confirm означает, что брокер взял ответственность за сообщение; если подтверждение потерялось в сети, издатель отправит сообщение повторно, поэтому потребитель должен дедуплицировать сообщения или обрабатывать их идемпотентно. Помогает флаг redelivered: если он не выставлен, сообщение точно не доставлялось раньше. Quorum queues — реплицированные очереди на Raft и рекомендуемый выбор для отказоустойчивости; с версии 4.0 у них по умолчанию лимит в 20 доставок, а зеркалирование классических очередей удалено.
| Вопрос | Kafka | RabbitMQ |
|---|---|---|
| Брокер принял запись | acks, идемпотентный producer | Publisher confirms |
| Обработка завершена | Commit offset | ack или nack сообщения |
| По умолчанию | At-least-once | At-least-once с ack |
| Как получить at-most-once | retries=0, commit до обработки | Автоматический ack |
| Exactly-once | Транзакции внутри Kafka | Нет, дедупликация у потребителя |
Как выбрать: сценарии
Начинайте с требований, а не с брендов: нужно ли хранить события после обработки, кому важен порядок и по какому ключу, сколько разных потребителей у одного события, нужна ли маршрутизация и как вы обработаете повтор. Если ответы — «хранить, перечитывать, порядок по ключу», выбор склоняется к Kafka; если «раздать задачи, подтвердить каждую, отказы отправить в dead letter» — к RabbitMQ.
Не опирайтесь на чужие цифры производительности: результат зависит от размера сообщений, режима подтверждений, репликации и железа, поэтому сравнивайте на своей нагрузке. И учитывайте эксплуатацию: команда, которая уверенно держит один брокер, часто выигрывает больше, чем от теоретически более подходящего второго.
| Сценарий | Скорее | Почему |
|---|---|---|
| Фоновые задачи: письма, отчёты | RabbitMQ, quorum queue | Поштучный ack, лимит доставок |
| Event sourcing, аналитика, CDC | Kafka | Хранение, replay, порядок по ключу |
| Маршрутизация по шаблонам ключей | RabbitMQ | Exchanges и bindings |
| RPC через брокер | RabbitMQ, Direct Reply-To | Ответ без отдельной очереди |
| Новый сервис читает историю | Kafka или RabbitMQ Streams | Неразрушающее чтение |
| Очередь задач рядом с Kafka 4.2+ | Kafka share groups | Один кластер, поштучный ack |
Как отвечать на собеседовании
Отвечайте через модель: «Kafka — распределённый лог с партициями и offset, RabbitMQ — брокер с маршрутизацией и очередями, где ack удаляет сообщение». Затем свяжите модель со сценарием, назовите гарантию доставки и место, где появятся дубликаты, и закончите тем, как обеспечите идемпотентность. Упоминание streams и share groups покажет, что вы следите за развитием обеих систем.
Подробные вопросы по каждому брокеру собраны в отдельных подборках. Пройдите обе и отметьте темы, где ответ пока держится на памяти, а не на понимании механизма.
- Обещать глобальный порядок во всём топике Kafka.
- Говорить «RabbitMQ не хранит сообщения»: durable-очереди и streams хранят.
- Считать exactly-once в Kafka сквозной гарантией до внешней базы.
- Путать publisher confirms и подтверждения потребителя.
Коротко
Частые вопросы
Можно ли использовать Kafka как очередь задач?
С Kafka 4.2 для этого есть share groups, готовые к production: поштучные подтверждения, подсчёт попыток и потребителей больше, чем партиций. Раньше очередь задач строили на consumer group, где параллелизм ограничен числом партиций, а прогресс подтверждается offset, а не отдельным сообщением.
Хранит ли RabbitMQ сообщения на диске?
Да. Quorum queues — durable и реплицированные, streams всегда персистентны и реплицированы. Но обычная очередь удаляет сообщение после подтверждения, поэтому перечитать его нельзя — для повторного чтения нужны streams.
Что выбрать для микросервисов на старте?
Тот брокер, сценарии которого у вас преобладают и который команда умеет эксплуатировать. Для адресных команд и фоновых задач чаще подходит RabbitMQ, для потока доменных событий, который читают несколько сервисов и аналитика, — Kafka. Начинайте с требований к хранению и порядку.
Есть ли в RabbitMQ consumer groups, как в Kafka?
Прямого аналога нет. Потребители одной очереди конкурируют за сообщения, а для fan-out каждой группе нужна своя очередь. В streams несколько потребителей читают один лог независимо, а single active consumer и super streams дают порядок внутри партиции.
Источники
Источники и редакционная политика
Сведения проверены 7 ноября 2026 г. Ссылки рядом с разделами указывают источники фактов и технических объяснений. Выводы, учебные сценарии и рекомендации по подготовке — редакционная работа RecallDeck.
От чтения к воспроизведению
Отрепетируйте полный цикл интервью.
RecallDeck возвращает сложные темы по расписанию и помогает удерживать в памяти язык, SQL, архитектуру и поведенческие истории.