Индекс помогает, когда условие отсекает малую долю строк и записано так, как построен индекс: тот же тип, колонка без функции, левый префикс составного ключа. Каждый индекс замедляет запись и занимает место, поэтому создавайте его под конкретный запрос и сравнивайте план до и после.
Как B-дерево находит строку
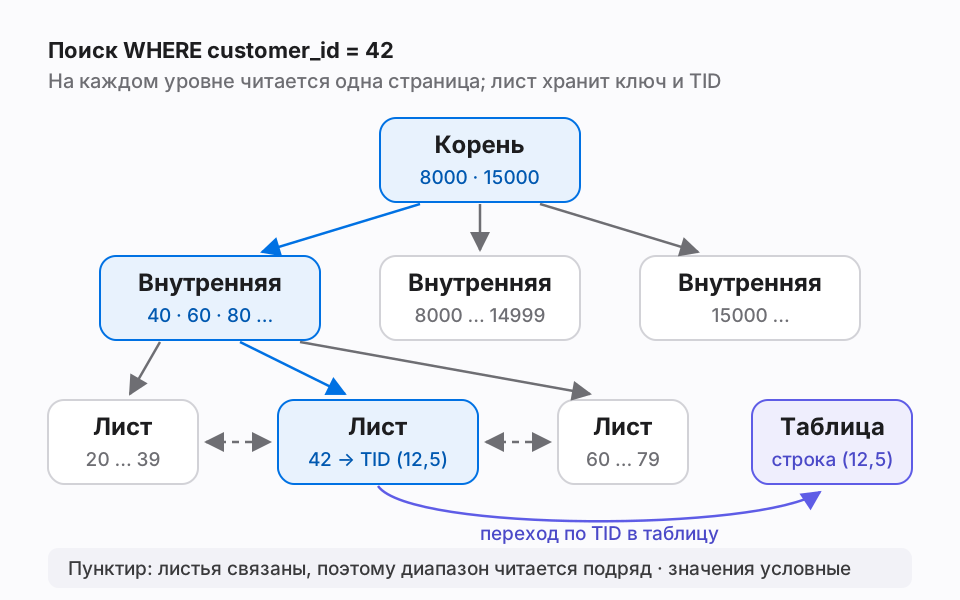
По умолчанию CREATE INDEX в PostgreSQL строит B-дерево. Это многоуровневая структура из страниц, обычно по 8 КБ: корень, внутренние страницы и листья. Внутренние страницы хранят разделители диапазонов, листья — отсортированные ключи и TID, адрес строки в таблице: номер страницы и позицию на ней. Поиск спускается от корня к листу, читая по одной странице на уровень, а страницы одного уровня связаны в список, поэтому BETWEEN или ORDER BY ... LIMIT читают диапазон подряд.
Логарифм возникает из ветвления: на странице помещаются сотни ключей (точное число зависит от их размера), каждый уровень умножает охват в сотни раз, и даже миллионам строк хватает нескольких уровней. Но найти TID — полдела: за каждой строкой ещё нужно сходить в таблицу. Если условию подходит заметная доля строк, тысячи случайных чтений страниц обходятся дороже одного последовательного прохода. Поэтому решает селективность — насколько малую долю строк оставляет условие, — а не сам факт наличия индекса.
План до и после: 25 строк из 500 000
Создадим таблицу заказов: у каждого из 20 000 клиентов по 25 заказов, статус 'new' у каждого двадцатого. EXPLAIN с ANALYZE, но без времени и стоимости показывает форму плана и фактические строки — этого хватает, чтобы увидеть механизм, а тайминги с ноутбука ничего не говорят о вашем проде. Без индекса PostgreSQL запустил Parallel Seq Scan: каждый из трёх процессов отбросил в среднем 166 658 строк (Rows Removed by Filter: 166658), чтобы вместе найти 25 нужных.
После CREATE INDEX план сменился на Bitmap Index Scan on orders_customer_idx (actual rows=25 loops=1) и Bitmap Heap Scan с Heap Blocks: exact=25. Индекс сначала собрал все 25 TID, затем PostgreSQL прочитал из таблицы 25 страниц в физическом порядке: заказы клиента 42 разбросаны по разным страницам. Выбор между обычным Index Scan и битмапом планировщик делает по оценке числа строк и их разброса по таблице.
CREATE TABLE orders (
  id          bigint PRIMARY KEY,
  customer_id int           NOT NULL,
  status      text          NOT NULL,
  email       text          NOT NULL,
  total       numeric(10,2) NOT NULL
);
INSERT INTO orders
SELECT g, (g::bigint * 7919) % 20000,
       CASE WHEN g % 20 = 0 THEN 'new' ELSE 'done' END,
       'User' || g || '@Example.com', (g % 500) + 0.99
FROM generate_series(1, 500000) AS g;
VACUUM ANALYZE orders;

EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT id, total FROM orders WHERE customer_id = 42;

CREATE INDEX orders_customer_idx ON orders (customer_id);
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT id, total FROM orders WHERE customer_id = 42;Составной индекс, левый префикс и Index Only Scan
Составной индекс (customer_id, total) отсортирован сначала по customer_id, а внутри — по total, как справочник по фамилии и имени. Условие customer_id = 42 AND total > 100 целиком попало в Index Cond. Фильтр только по total = 10.99 (1000 строк, 0,2% таблицы) PostgreSQL 17 выполнил через Parallel Seq Scan: формально такой индекс годится и для условия по второй колонке, но читать пришлось бы весь индекс. Правило из документации: диапазон сканирования сужают равенства по ведущим колонкам плюс неравенство по первой колонке без равенства. Отсюда порядок: сначала колонки с равенством, потом с диапазоном. В PostgreSQL 18 появился skip scan, который позволяет использовать составной индекс и без условия на первую колонку, — проверяйте план на своей версии.
Покрывающий индекс решает другую задачу: если все нужные запросу колонки есть в индексе, таблицу можно не читать. INCLUDE (total) добавляет колонку в индекс, не делая её частью ключа, и план стал Index Only Scan с Heap Fetches: 0. Но обойтись без таблицы удаётся только для страниц, которые карта видимости отмечает как полностью видимые. После UPDATE 25 строк счётчик вырос до Heap Fetches: 50: в индексе лежали записи и старых, и новых версий строк, их страницы потеряли отметку в карте видимости, и видимость каждой записи пришлось проверять в таблице. После VACUUM счётчик снова стал 0.
DROP INDEX orders_customer_idx;
CREATE INDEX orders_cust_total_idx ON orders (customer_id, total);
ANALYZE orders;
EXPLAIN (COSTS OFF) SELECT id FROM orders WHERE customer_id = 42 AND total > 100;
EXPLAIN (COSTS OFF) SELECT id FROM orders WHERE total = 10.99;  -- 1000 строк из 500 000

DROP INDEX orders_cust_total_idx;
CREATE INDEX orders_customer_cov_idx ON orders (customer_id) INCLUDE (total);
VACUUM ANALYZE orders;
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT customer_id, total FROM orders WHERE customer_id = 42;   -- Heap Fetches: 0
UPDATE orders SET total = total + 1 WHERE customer_id = 42;
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT customer_id, total FROM orders WHERE customer_id = 42;   -- Heap Fetches: 50
VACUUM orders;
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT customer_id, total FROM orders WHERE customer_id = 42; -- снова 0Четыре причины, по которым индекс не используется
С индексами по email и status мы проверили типичные ловушки. В большинстве случаев план одинаковый — Parallel Seq Scan, а различается строка Filter. Её стоит читать внимательно: там выражение, которое реально вычисляется для каждой строки, и оно часто сразу объясняет, почему индекс не подошёл.
Исправления зависят от причины. Для функции нужен индекс по тому же выражению, что в запросе. Типы приводят на стороне литерала или параметра, а не колонки; драйверы и ORM иногда сами передают параметр не того типа, поэтому смотрите на Filter. Для поиска по подстроке B-tree не подходит в принципе: нужен триграммный индекс GIN или GiST из расширения pg_trgm либо полнотекстовый поиск. Низкую селективность лечит не индекс, а другой запрос или частичный индекс под редкое значение.
- Функция над колонкой: Filter: (lower(email) = 'user42@example.com'::text). Индекс хранит email, а не lower(email).
- Несовпадение типов: Filter: ((customer_id)::numeric = 42.0). Литерал 42.0 — numeric, поэтому приводится колонка, и индекс по int не подходит.
- Ведущий %: Filter: (email ~~ '%42@Example.com'::text) — начала строки нет, спускаться по дереву некуда. Префиксный LIKE 'User42@%' тоже ушёл в Seq Scan, но уже из-за collation: обычный B-tree обслуживает LIKE только при локали C или POSIX, а наша база создана с libc-локалью C.UTF-8. Нужен индекс с классом операторов text_pattern_ops или с COLLATE "C". В базе со встроенным провайдером builtin и той же C.UTF-8 хватило обычного индекса.
- Селективность: status = 'done' (475 000 строк из 500 000) — Seq Scan, хотя индекс есть; status = 'new' (25 000 строк) — Index Scan using orders_status_idx.
CREATE INDEX orders_email_idx  ON orders (email);
CREATE INDEX orders_status_idx ON orders (status);
ANALYZE orders;
-- 1. Функция над колонкой
EXPLAIN (COSTS OFF) SELECT id FROM orders WHERE lower(email) = 'user42@example.com';
-- 2. Типы не совпадают: int сравнивается с numeric
EXPLAIN (COSTS OFF) SELECT id FROM orders WHERE customer_id = 42.0;
-- 3. Ведущий % и префиксный LIKE без text_pattern_ops (libc-локаль C.UTF-8)
EXPLAIN (COSTS OFF) SELECT id FROM orders WHERE email LIKE '%42@Example.com';
EXPLAIN (COSTS OFF) SELECT id FROM orders WHERE email LIKE 'User42@%';
-- 4. Селективность: 'done' у 95% строк, 'new' у 5%
EXPLAIN (COSTS OFF) SELECT id FROM orders WHERE status = 'done';
EXPLAIN (COSTS OFF) SELECT id FROM orders WHERE status = 'new';B-tree, Hash, GIN, GiST и BRIN: что когда выбирать
B-tree покрывает большинство задач: равенство, диапазоны, сортировку, IS NULL и префиксный LIKE с оговоркой про collation. Остальные типы закрывают то, с чем он не справляется. GIN — инвертированный индекс для значений из многих элементов: массивов, jsonb, полнотекстовых документов. GiST — каркас для геометрии, диапазонов и поиска ближайших соседей. BRIN хранит сводку, например минимум и максимум, по диапазонам соседних страниц и хорош для огромных таблиц, где значения коррелируют с физическим порядком строк, как время вставки в журнале событий.
Ещё два инструмента не зависят от типа. Частичный индекс строится только по строкам, подходящим под WHERE: orders_new_idx по 25 000 новым заказам занял 208 kB, а планировщик берёт его, лишь когда условие запроса подразумевает status = 'new'. Индекс по выражению хранит результат функции, например lower(email). Оба исправления в нашем прогоне дали Index Scan, а префиксный LIKE с text_pattern_ops превратился в диапазон: Index Cond: ((email ~>=~ 'User42@'::text) AND (email ~<~ 'User42A'::text)).
CREATE INDEX orders_email_lower_idx  ON orders (lower(email));
CREATE INDEX orders_email_prefix_idx ON orders (email text_pattern_ops);
CREATE INDEX orders_new_idx ON orders (customer_id) WHERE status = 'new';
ANALYZE orders;
EXPLAIN (COSTS OFF) SELECT id FROM orders WHERE lower(email) = 'user42@example.com';
EXPLAIN (COSTS OFF) SELECT id FROM orders WHERE email LIKE 'User42@%';
EXPLAIN (COSTS OFF) SELECT id FROM orders WHERE status = 'new' AND customer_id = 40;
SELECT relname, pg_size_pretty(pg_relation_size(oid)) AS size
FROM pg_class WHERE relname LIKE 'orders%' ORDER BY relname;| Тип | Когда нужен | Пример условия |
|---|---|---|
| B-tree | равенство, диапазоны, сортировка | created_at >= '2026-11-01' |
| Hash | только равенство | token = 'abc' |
| GIN | массивы, jsonb, полнотекстовый поиск | tags @> ARRAY['sql'] |
| GiST | геометрия, диапазоны, ближайшие соседи | during && tstzrange(a, b) |
| BRIN | огромные журналы, значения растут со вставкой | logged_at BETWEEN a AND b |
Цена индекса и ответ на собеседовании
Индекс — не бесплатное ускорение. Каждый INSERT добавляет запись во все индексы таблицы (в частичный — если строка подходит под его условие), а UPDATE в MVCC создаёт новую версию строки и, как правило, новые записи в индексах. Исключение — HOT-обновление: если не изменилась ни одна индексируемая колонка и на странице есть место, новые записи в индексах не нужны. Значит, лишний индекс на часто обновляемой колонке ещё и отнимает у таблицы HOT. В нашем стенде таблица занимает 37 MB, а семь индексов вместе — около 86 MB.
Ответ на вопрос «как работают индексы» укладывается в минуту: B-дерево и логарифм, TID и поход в таблицу, селективность, левый префикс, покрывающие индексы и карта видимости, цена записи. Дальше обычно просят пример из практики: опишите запрос, план до, индекс и план после. Если индекс создают на живой таблице, упомяните CREATE INDEX CONCURRENTLY: он не блокирует запись, но работает дольше, не запускается внутри транзакции, а при сбое оставляет индекс в состоянии INVALID.
Закрепите на своём стенде
Повторите скрипты на одноразовой базе и для каждого запроса сначала предскажите план, потом проверьте. Затем поменяйте одно условие — распределение статусов, порядок колонок, тип литерала — и снова предскажите. Такие маленькие эксперименты запоминаются лучше, чем список правил, а заодно дают готовый пример «план до и после» для собеседования.
Перед собеседованием пригодятся сборник вопросов по SQL и PostgreSQL и статья о пагинации, где индекс под ORDER BY решает практическую задачу. Вопросы о типах индексов, левом префиксе и цене записи удобно вынести на карточки и повторять, пока ответ не станет коротким и точным.
Коротко
Частые вопросы
Создаёт ли PostgreSQL индекс на внешний ключ автоматически?
Нет. Индексы автоматически появляются для PRIMARY KEY и UNIQUE, но не для FOREIGN KEY. Для колонки внешнего ключа документация советует подумать об индексе самостоятельно: при удалении или изменении строки в родительской таблице PostgreSQL ищет ссылающиеся строки, и без индекса это полный проход по дочерней таблице.
Чем кластерный индекс отличается от обычного?
В InnoDB строки таблицы хранятся в самом кластерном индексе, и обычно это первичный ключ. В PostgreSQL все индексы вторичные: таблица лежит отдельно, а команда CLUSTER лишь однократно переупорядочивает её по индексу, и новые строки этот порядок не поддерживают.
Почему после CREATE INDEX план не изменился?
Частые причины: таблица маленькая и Seq Scan действительно дешевле, условие отбирает много строк, запрос записан не под индекс — функция, другой тип, — либо статистика устарела. Выполните ANALYZE, прочитайте строку Filter в плане и сравните оценку числа строк с фактической.
Нужен ли индекс на колонку с двумя значениями, например boolean?
Обычно нет: если каждое значение встречается часто, планировщик выберет Seq Scan. Исключение — редкое значение, по которому часто ищут, например немногие необработанные заказы. Для него подойдёт частичный индекс с WHERE processed = false: он маленький и не тратит место на частое значение.
Источники
Источники и редакционная политика
Сведения проверены 7 ноября 2026 г. Ссылки рядом с разделами указывают источники фактов и технических объяснений. Выводы, учебные сценарии и рекомендации по подготовке — редакционная работа RecallDeck.
От чтения к воспроизведению
Отрепетируйте полный цикл интервью.
RecallDeck возвращает сложные темы по расписанию и помогает удерживать в памяти язык, SQL, архитектуру и поведенческие истории.