CAP — не меню «два из трёх», а теорема о линеаризуемом объекте: если сообщения между узлами теряются, нельзя одновременно гарантировать линеаризуемость и ответ каждого живого узла. Выбор делают для конкретной операции на время раздела, а в обычном режиме согласованность оплачивают задержкой — это и добавляет PACELC.
Что именно доказали Gilbert и Lynch
Эрик Брюер высказал идею 19 июля 2000 года в докладе «Towards Robust Distributed Systems» на конференции PODC: веб-сервис не может одновременно обеспечить согласованность, доступность и устойчивость к разделению сети. На слайде она названа теоремой, но доказательства в докладе нет, поэтому Сет Гилберт и Нэнси Линч в статье 2002 года называют её гипотезой Брюера — и доказывают, сначала формализовав термины. Формальные определения уже бытовых слов, и большая часть путаницы на собеседованиях начинается именно здесь.
C — атомарная, или линеаризуемая, согласованность объекта чтения и записи: у всех операций есть общий порядок, каждая выглядит мгновенной, поэтому чтение после завершённой записи возвращает это значение или более новое. A — каждый запрос, полученный неупавшим узлом, получает ответ; срок не ограничен, но исключений нет. P — сеть может терять сколько угодно сообщений между узлами. Теорема 1: в асинхронной модели нельзя реализовать такой объект с гарантией A и C во всех справедливых исполнениях, включая исполнения с потерей сообщений. Следствие 1.1 идёт дальше: узел не отличает потерянное сообщение от задержанного, поэтому при доступности во всех исполнениях нельзя обещать C даже в тех, где ни одно сообщение не потерялось.
| Буква | Смысл в доказательстве | Чем не является |
|---|---|---|
| C | Линеаризуемость одного объекта | Буквой C из ACID |
| A | Ответ от каждого живого узла | Процентом аптайма из SLA |
| P | Сеть теряет любые сообщения | Режимом, который можно выключить |
Почему «два из трёх» — упрощение, а теорема не устарела
Раздел сети не выбирают, его переживают: если у системы больше одного узла, сообщения рано или поздно теряются или опаздывают. Реальный вопрос звучит так: что делает узел, который не может связаться с остальными, — отказывает и сохраняет C или отвечает и сохраняет A. «CA» честно описывает только систему, где раздела не бывает, например один сервер. Сам Брюер в статье «CAP Twelve Years Later» (2012) назвал формулу «два из трёх» вводящей в заблуждение: разделы редки, без них жертвовать C или A незачем, а выбор можно делать по операциям и по данным.
Запрос «cap теорема устарела» смешивает две вещи. Доказательство верно, но его определения узкие: линеаризуемость одного регистра и сколь угодно долгое ожидание ответа мало говорят о транзакциях, задержках и частичных сбоях. Брюер предлагает практический цикл: заметить раздел по таймауту, перейти в явный режим раздела с ограничением части операций, а после восстановления связи примирить данные и компенсировать ошибки. Мартин Клеппман в работе 2015 года разбирает неоднозначности определений и предлагает оценивать, насколько задержка операции зависит от сетевой задержки. Устарела не теорема, а привычка клеить базе ярлык по треугольнику.
PACELC: какую цену платят без всякого раздела
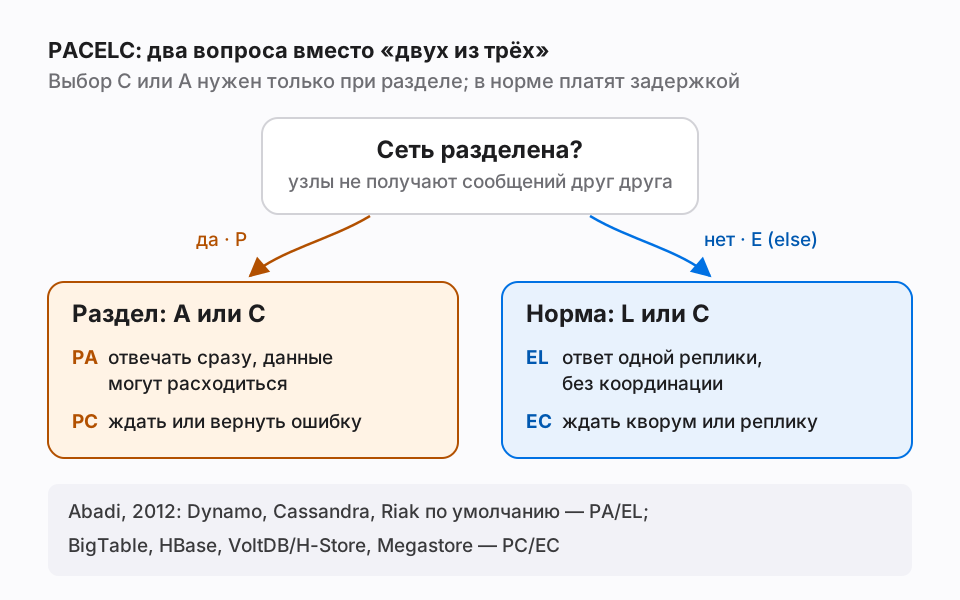
Дэниел Абади в 2012 году заметил, что CAP описывает редкий случай, а реплицированная система платит каждый день: чтобы прочитать согласованное значение или подтвердить запись, нужно дождаться другой реплики, иногда в другом дата-центре. Его формулировка PACELC: если есть раздел (P), система выбирает между A и C; иначе (E) — между задержкой (L) и согласованностью (C). Вторая половина касается только систем, которые реплицируют данные.
Абади классифицирует системы в версиях того времени. Dynamo, Cassandra и Riak по умолчанию — PA/EL: при разделе жертвуют согласованностью ради доступности, а в норме — ради задержки. Увеличение R + W делает их согласованнее ценой задержки, но, по словам автора, не даёт согласованности в смысле Gilbert и Lynch даже при R + W > N. VoltDB/H-Store, Megastore, BigTable и HBase — PC/EC, PNUTS — PC/EL. Это снимок 2012 года: прежде чем повторять ярлык на собеседовании, сверьтесь с документацией текущей версии.
Живой случай: синхронная реплика PostgreSQL 17 недоступна
Я поднял локально primary и реплику PostgreSQL 17.9 (pg_basebackup -R, application_name = standby1) и включил synchronous_standby_names = 'standby1'. В pg_stat_replication реплика получила sync_state = sync, первая вставка в balance вернулась сразу и была видна на реплике. Затем реплику остановили. Следующая вставка не вернулась: в pg_stat_activity её процесс ждал события SyncRep типа IPC. После pg_cancel_backend клиент получил WARNING о прерванном ожидании и строку DETAIL: транзакция уже закоммичена локально, но могла не попасть на реплику. SELECT на primary показал обе строки.
Для записей primary выбрал C: без подтверждения реплики он не сообщает об успехе, а документация предупреждает, что такие коммиты могут не завершиться вовсе. Отмена ожидания не откатывает транзакцию: после WARNING клиент всё равно получает INSERT 0 1, то есть строка есть на primary, но не обязательно на реплике. Клиент, который просто оборвал соединение по таймауту, не знает даже этого, поэтому повторять запрос нужно идемпотентно. SET synchronous_commit = local вернул INSERT 0 1 сразу — осознанный выбор доступности для одной сессии. Асинхронная репликация устроена наоборот: коммит не ждёт, но при failover могут потеряться транзакции в пределах отставания. Обнаружение сбоя и переключение PostgreSQL на себя не берёт, а старый primary после переключения нужно изолировать, иначе два узла сочтут себя главными.
-- primary: подтверждать коммит только после ответа standby1
ALTER SYSTEM SET synchronous_standby_names = 'standby1';
SELECT pg_reload_conf();
SELECT application_name, sync_state FROM pg_stat_replication;
--  standby1 | sync

-- standby1 остановлен; сессия 1:
INSERT INTO balance VALUES (2, 50);   -- не возвращается

-- сессия 2:
SELECT wait_event_type, wait_event FROM pg_stat_activity
WHERE query LIKE 'INSERT INTO balance%';
--  IPC | SyncRep
SELECT pg_cancel_backend(pid) FROM pg_stat_activity
WHERE query LIKE 'INSERT INTO balance%';

-- сессия 1 получает:
-- WARNING:  canceling wait for synchronous replication due to user request
-- DETAIL:  The transaction has already committed locally, but might not
--          have been replicated to the standby.
-- INSERT 0 1

-- осознанно выбрать доступность для одной сессии:
SET synchronous_commit = local;
INSERT INTO balance VALUES (3, 10); -- INSERT 0 1 без ожиданияПримеры систем: ярлык получает операция, а не продукт
Документация современных хранилищ описывает настройки, а не одну букву. Cassandra прямо говорит о компромиссе между согласованностью и доступностью для каждой операции через consistency levels; при W + R > RF подтверждённые записи видны последующим чтениям. В DynamoDB чтение по умолчанию eventually consistent, ConsistentRead работает для таблиц и локальных индексов, а чтения из глобальных вторичных индексов и streams всегда eventually consistent.
etcd по умолчанию линеаризует операции через Raft, но позволяет serializable-чтение, которое может вернуть устаревшие данные; при разделе доступна сторона большинства, а лидер на стороне меньшинства уходит. ZooKeeper проводит записи через кворум и применяет обновления клиента в порядке отправки, но не обещает двум клиентам одинаковую картину в один момент: чтение обслуживает сервер, к которому подключён клиент, и без sync() перед чтением можно получить старое значение. Экспериментальный read-only режим, выключенный по умолчанию, позволяет отрезанному от кворума серверу отдавать чтения. Даже «CP-системы» различаются в деталях.
| Система | Что настраивается | Цена согласованности |
|---|---|---|
| PostgreSQL | synchronous_commit, синхронные реплики | Коммит ждёт реплику |
| Cassandra | Consistency level на операцию | Ожидание большего числа реплик |
| DynamoDB | ConsistentRead в запросе | Вдвое дороже eventually-чтения |
| etcd | Linearizable или serializable чтение | Чтение проходит через Raft |
| ZooKeeper | sync() перед чтением | Лишний вызов перед чтением |
- Apache Cassandra: Dynamo, Tunable Consistency
- Amazon DynamoDB: Read consistency
- etcd v3.6: KV API guarantees
- etcd v3.6: Failure modes, network partition
- Apache ZooKeeper: Programmer's Guide, Consistency Guarantees
- Apache ZooKeeper: Internals, quorum commit
- Apache ZooKeeper: Administrator's Guide, Read Only Mode
Как отвечать на собеседовании
Хороший ответ укладывается в четыре шага. Определите буквы строго: линеаризуемость, ответ от любого живого узла, потеря сообщений. Скажите, что выбор между C и A возникает только во время раздела и делается для операции, а не для всей системы. Добавьте PACELC: в обычном режиме согласованность стоит задержки. Закончите примером из своей системы: списание баланса на стороне меньшинства лучше отклонить, а счётчик просмотров можно принять и слить после восстановления связи.
Будьте готовы к уточнениям. Что увидит клиент, подключённый к меньшинству: ошибку, ожидание или старые данные? Как система узнаёт о разделе, если таймаут может означать и просто медленную сеть? Что произойдёт при восстановлении связи — кто победит в конфликте и как компенсировать неверные решения? Ответы на эти вопросы показывают, что вы понимаете механизм, а не помните картинку.
- Называть распределённую базу «CA»: так можно описать только систему без раздела.
- Путать C из CAP с C из ACID и с уровнями изоляции транзакций.
- Считать A процентом аптайма: в теореме это ответ каждого живого узла.
- Ставить продукту ярлык CP или AP, не назвав настройки и тип операции.
- Забывать про клиента: таймаут не говорит, применилась ли запись.
Практика: проверьте себя на своей системе
Возьмите систему, с которой работали, и для двух операций — записи денег и чтения ленты — выпишите поведение при разделе и цену согласованности в норме. Затем найдите в документации реальные настройки: synchronous_commit, consistency level, тип чтения. Такой разбор полезнее заученного треугольника и сразу даёт пример для собеседования.
Для повторения пригодятся подборки вопросов по system design и масштабированию backend. RecallDeck поможет возвращаться к определениям по расписанию, а разбор своей системы держите отдельной письменной практикой.
Коротко
Частые вопросы
Как коротко доказать CAP-теорему?
Разделите узлы на группы G1 и G2 и потеряйте все сообщения между ними. Запишите новое значение в G1: доступность требует, чтобы запись завершилась. Затем прочитайте его в G2: ответ тоже обязателен, но G2 ничего не знает о записи и вернёт старое значение — линеаризуемость нарушена. Это и есть идея доказательства Gilbert и Lynch.
Можно ли назвать PostgreSQL CP или AP системой?
К одиночному серверу теорема почти ничего не добавляет. С репликами поведение задают synchronous_commit, синхронные standby и внешний инструмент переключения. Синхронная реплика при сбое заставляет коммит ждать, асинхронная отвечает сразу, но при failover рискует потерять подтверждённые транзакции.
Чем линеаризуемость отличается от сериализуемости?
Линеаризуемость относится к отдельным операциям над объектом: каждая выглядит мгновенной и согласована с реальным временем. Сериализуемость относится к транзакциям: результат равен какому-то последовательному порядку, не обязательно совпадающему с порядком во времени. etcd обещает оба свойства сразу — strict serializability.
Значит ли eventual consistency, что данные будут неверными?
Нет. Она обещает, что без новых записей реплики со временем сойдутся, но не ограничивает, сколько чтений до этого вернут старое значение. Для ленты это допустимо, для баланса нужен сильный режим: ConsistentRead в DynamoDB или подходящий consistency level в Cassandra.
Источники
Источники и редакционная политика
Сведения проверены 7 ноября 2026 г. Ссылки рядом с разделами указывают источники фактов и технических объяснений. Выводы, учебные сценарии и рекомендации по подготовке — редакционная работа RecallDeck.
- Gilbert, Lynch — Brewer's Conjecture and the Feasibility of Consistent, Available, Partition-Tolerant Web Services (2002)
- Eric Brewer — CAP Twelve Years Later: How the "Rules" Have Changed (IEEE Computer, 2012)
- Daniel Abadi — Consistency Tradeoffs in Modern Distributed Database System Design (IEEE Computer, 2012)
- PostgreSQL 17: Log-Shipping Standby Servers, Synchronous Replication
- Apache Cassandra: Dynamo, Tunable Consistency
- etcd v3.6: KV API guarantees
От чтения к воспроизведению
Отрепетируйте полный цикл интервью.
RecallDeck возвращает сложные темы по расписанию и помогает удерживать в памяти язык, SQL, архитектуру и поведенческие истории.